UB-DataScience-CapstoneProject
Introducción al Data Science y al Machine Learning. http://www.ub.edu/datascience/postgraduate/
Atrás – Índice – Siguiente
Datos
Para este proyecto se emplea el Kvasir-Capsule dataset disponible en link.
Se trata de un dataset de video del que hay disponibles una serie de imágenes etiquetadas con hasta 14 categorías así como gran cantidad de imágenes y videos sin etiquetar.
El Kvasir-Capsule dataset
Las imágenes corresponden a regiones y lesiones del sistema digestivo humano. Dado que algunas clases están excesivamente infrarepresentadas, se han tomado las siguientes 11 clases como válidas para realizar este estudio.
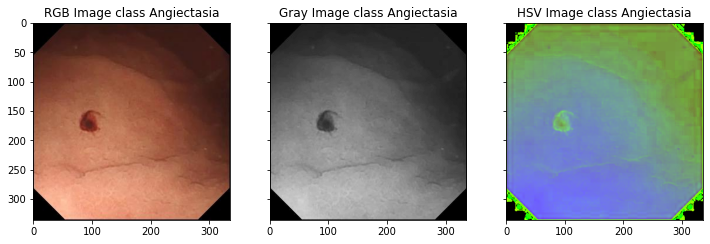
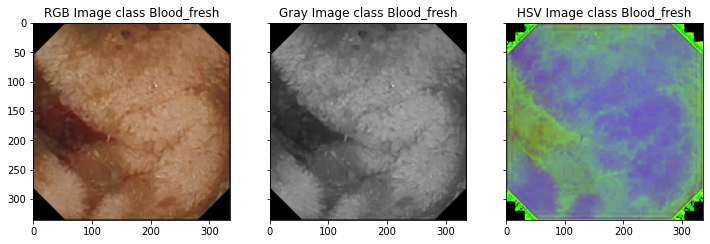
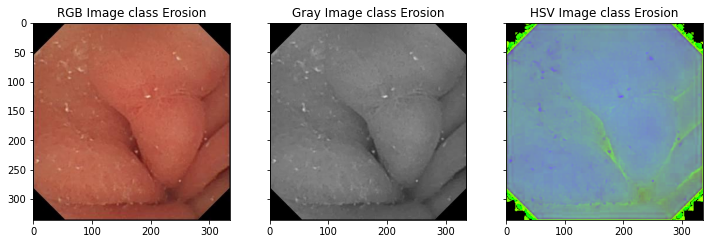
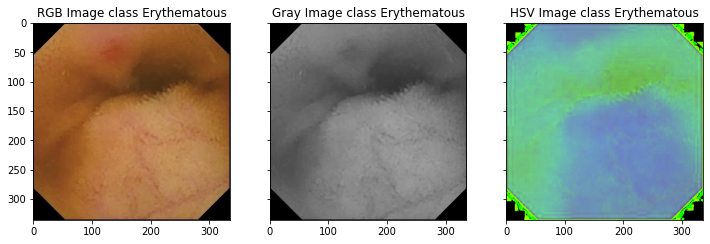
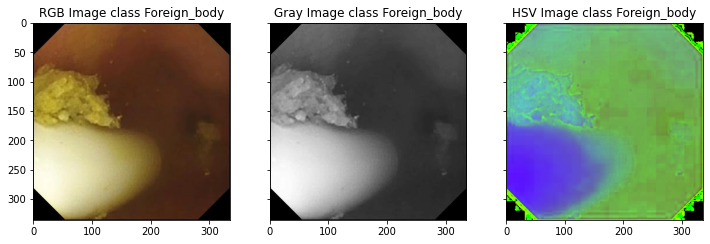
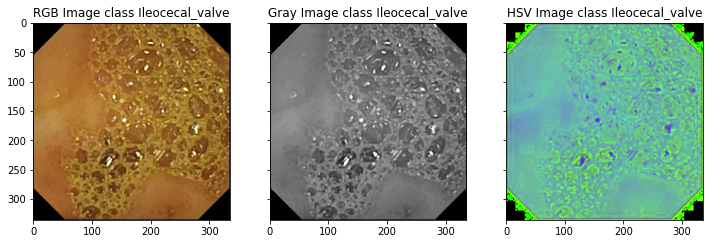
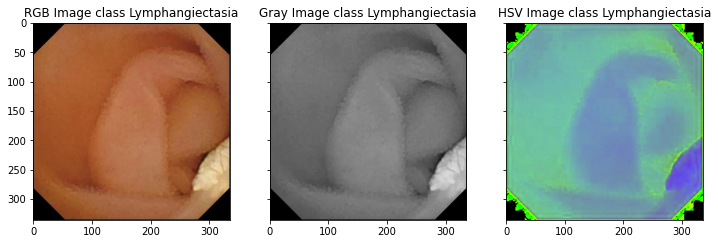
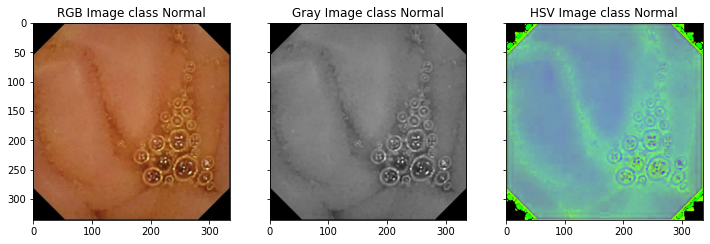
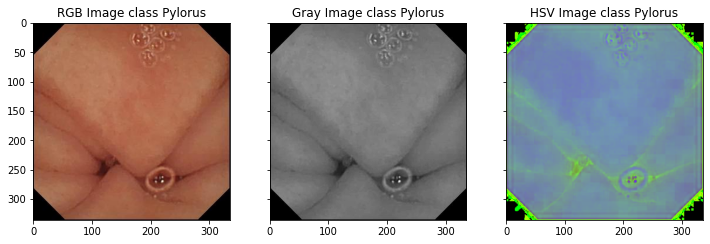
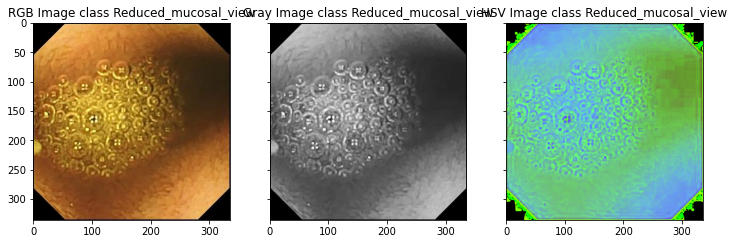
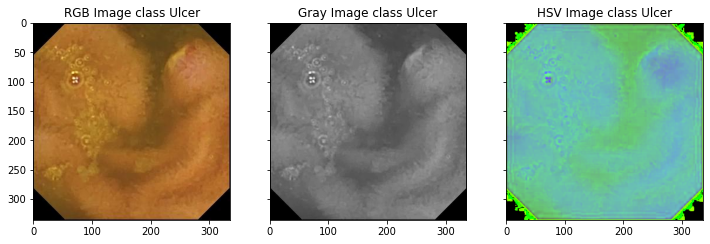
Las imágenes son de un ámbito muy específico (campo de las ciencias de la salud) del que el autor se considera lego, más allá del sentido común. La simple inspección de las imágenes genera bastante confusión puesto que no es sencillo deducir la etiqueta asignada y surgen dudas (compatibles con la ignorancia en la materia) de la idoneidad del etiquetado.
Análisis del dataset
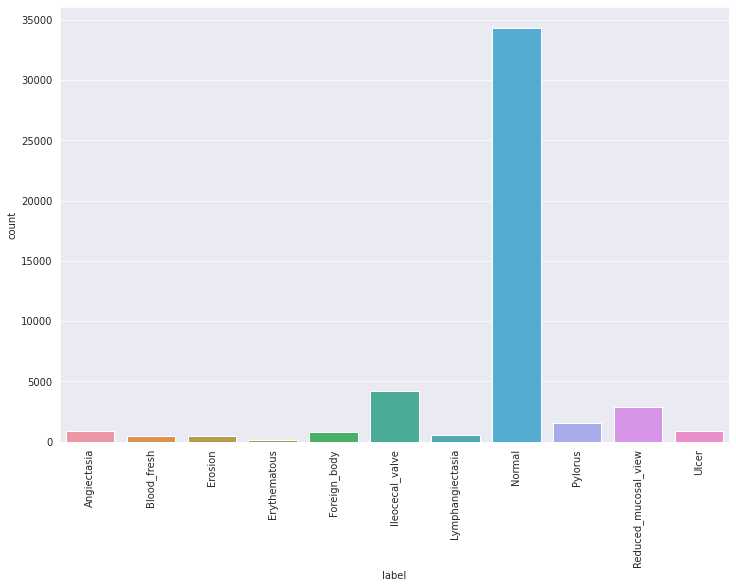
El número de imágenes presente en todo el dataset oculta la incómoda realidad de muchos datasets: desbalanceo entre clases, es decir, no hay la misma cantidad de imágenes para cada clase.
| Id | Clase | Número de muestras |
|---|---|---|
| 0 | Angiectasia | 866 |
| 1 | Blood_fresh | 446 |
| 2 | Erosion | 506 |
| 3 | Erythematous | 159 |
| 4 | Foreign_body | 776 |
| 5 | Ileocecal_valve | 4.189 |
| 6 | Lymphangiectasia | 592 |
| 7 | Normal | 34.338 |
| 8 | Pylorus | 1.529 |
| 9 | Reduced_mucosal_view | 2.906 |
| 10 | Ulcer | 854 |
Este desbalanceo es palmario al realizar un histograma de frecuencia de todo el dataset.
Datos de entrenamiento y validación
Este trabajo se considera una aproximación al problema presentado, con fines didácticos, por lo que tomé la decisión de aplicar los modelos a todo el dataset, reservando un 30% para validación.
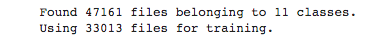
Los datos son alimentados en el sistema via un objeto Dataset que toma las imágenes a 3 canales RGB y las resamplea a un tamaño 100x100 píxels, para facilitar el entrenamiento y para que el entorno de proceso fuera capaz de aceptar los datos sin exceder los límites de RAM y capacidades del GPU asignado.